
Az Anthropic 2026. november 2-án közzétette a FlashProve kutatási prototípust, amely kriptográfiai proofot készít egy modell futtatásáról. A rendszer célja, hogy a szolgáltató a modell súlyainak felfedése nélkül igazolhassa: az ellenőrzött tokent az a modell állította elő, amelynek súlyaihoz korábban commitmentet tett közzé. A vállalat kutatási oldala a Frontier Red Team munkái között sorolja fel a közleményt.
2026. november 3-án ez még nem indokol szolgáltatóváltást vagy felárat. A FlashProve szolgáltatásként nem érhető el sem Claude-hoz, sem más, felhőben kínált kereskedelmi modellhez. A modell azonosságát jelenleg szerződéssel, naplózással és a szolgáltató átvilágításával kezelheted.
Mire ad igazolást a FlashProve?
A FlashProve azt igazolja, hogy a megadott tokent az a modell állította elő az adott promptból, amelynek súlyaihoz a szolgáltató korábban commitmentet tett közzé.
A szolgáltató először közzétesz egy rövid commitmentet, amely egy meghatározott súlykészlethez kötődik. A modell futtatása után proofot készít. A felhasználó a commitment, a prompt és a válasz birtokában ellenőrizheti az állítást anélkül, hogy hozzáférne a súlyokhoz vagy maga is lefuttatná a modellt.
Az Anthropic szerint a zkSNARK-alapú proof elrejti a súlyokat és a köztes számításokat. A modell architektúrája látható marad. A hash-alapú konstrukciót a vállalat kvantumszámítógépes támadásokkal szemben is biztonságosnak írja le.
Ez főként akkor számít, ha egy harmadik fél routerként továbbítja a kérést, vagy ha egy auditornak igazolnia kell, melyik modell dolgozott fel egy adott bemenetet. Az elkészült szöveg minőségéből önmagában nem lehet megbízhatóan megállapítani a modell azonosságát.
Használható-e már Claude vagy más kereskedelmi modell ellenőrzésére?
A FlashProve jelenlegi változata nem használható Claude vagy más, felhőben kínált kereskedelmi modell ellenőrzésére.
A kísérlet a nyilvánosan elérhető, 4 bites Llama 4 Maverick súlyokra épült. Ez egy 400 milliárd paraméteres Mixture-of-Experts modell, amely tokenenként körülbelül 17 milliárd paramétert aktivál. A FlashProve ezt a szerkezetet használja ki, ezért az eredmények nem vihetők át automatikusan más architektúrákra.
A proof a modell egész számokkal számoló változatának greedy decodinggal kapott eredményére vonatkozik. A lebegőpontos futtatás vagy a sampled decoding eltérő tokent adhat, amely már nem egyezik a proofban szereplő számítással. A rendszer legfeljebb 1 024 tokenes kontextust kezel, és egy proof egy tokent ellenőriz az adott ablakban. A proof kötegekben, a modell futtatása után készül, ezért nem igazolja automatikusan egy hosszú válasz minden tokenjét.
Az Anthropic egy külön projektben aláírja saját inference-forgalmát, majd megbízható szerveren újraszámolja az eredményt. Ez nem a FlashProve kereskedelmi használata. A vállalat ezt a tágabb célt inference verification néven említi.
Mit mutatnak a közölt teljesítményadatok?
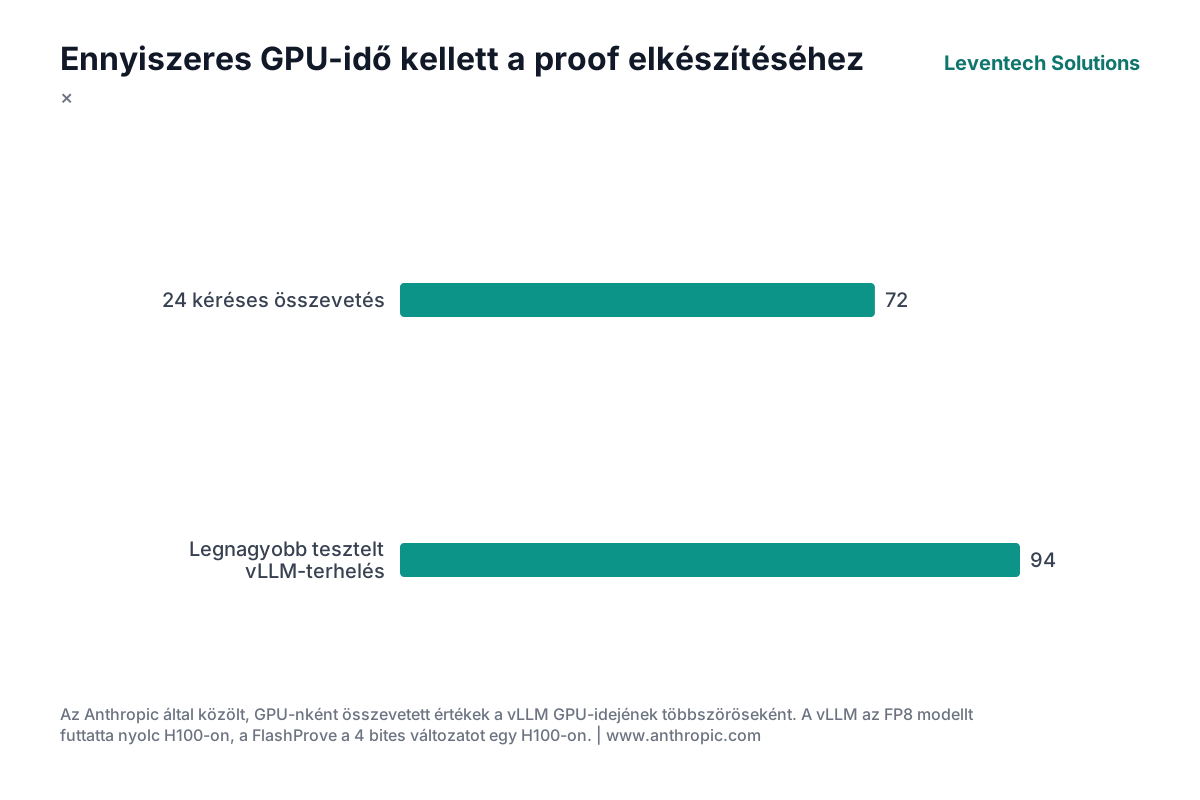
Az Anthropic mérései szerint egy proofot CPU-val másodpercek alatt lehet ellenőrizni. Az elkészítése a vizsgált beállítások mellett 72–94-szer annyi GPU-időt igényelt, mint a modell futtatása proof nélkül.
| Mutató | Közölt érték | Tesztfeltétel |
|---|---|---|
| A proof elkészítésének sebessége | 110 token/másodperc | 24 kéréses köteg, egy H100 és 24 CPU-mag |
| Proof mérete | 18,78 MB | Egy proof kérésenként |
| Ellenőrzési idő | 17 másodperc | 24 CPU-szál, GPU nélkül |
| Ellenőrzési idő | 21 másodperc | Egy CPU-szál, GPU nélkül |
| GPU-időigény | körülbelül 72-szeres | vLLM-mel összevetve, azonos 24 kéréses kötegben |
| GPU-időigény | körülbelül 94-szeres | A kipróbált legnagyobb vLLM-terhelés mellett |
Ezek gyártói mérések. A vLLM az FP8 modellváltozatot nyolc H100-on futtatta, míg a proof elkészítése a 4 bites változattal egy H100-on történt. Az eredményeket GPU-nként vetették össze. Az arányok erre a tesztre vonatkoznak, ezért nem alkalmazhatók automatikusan Claude-ra, dense modellekre vagy más hardverre.
A proof elkészítéséhez egy 80 GB-os GPU és mellette körülbelül 290 GB rendszermemória elegendő. A modellhez tartozó commitment elkészítése körülbelül 39 percig tartott. Egy commitment körülbelül 16 millió kéréshez használható, utána újat kell készíteni. A kiadás nem tartalmaz kereskedelmi árat, SLA-t vagy szolgáltatási feltételeket, ezért ezekből az adatokból nem készíthető teljes vállalati költségbecslés.
Ha a modellválasztást, a routingot és a naplózást egy rendszerben szeretnéd megtervezni, a vállalati AI-megoldások áttekintése segít kijelölni a követelményeket. Vállalati AI-megoldások
Mit kérj most a modell szolgáltatójától és a routertől?
Kérd meg a szolgáltatót, hogy dokumentálja, melyik modell szolgálta ki a kérést, mikor léphet működésbe a fallback, és milyen adat támasztja alá a naplóban szereplő modellazonosítót.
- Kérdezd meg, hogyan naplózzák a kért és a ténylegesen használt modell azonosítóját.
- Tisztázd, hogy a router milyen feltételekkel válthat másik modellre, régióra vagy szolgáltatóra.
- Kérj előzetes értesítést a modellverzió, a router szabályai vagy a fallback módosítása előtt.
- Rögzítsd, mennyi ideig őrzik meg a modellazonosítót, az időbélyeget és a router döntésének nyomát.
- Kérdezd meg, exportálható-e az auditnapló, és összevethető-e a saját alkalmazásnaplóddal.
- Kérj külön választ arra, hogy a napló szerződéses állítás vagy technikailag ellenőrizhető igazolás.
A napló azt mutatja meg, mit jegyzett fel a rendszer. Nem nyújt ugyanolyan kriptográfiai bizonyosságot, mint a modell súlyaihoz kötött proof. A szélesebb modellválasztáshoz használd a zárt vállalati AI-modellek összehasonlítását. Ha felhőpiactéren keresztül vásárolsz, az OpenAI-modellek Google Cloud Marketplace-beszerzéséről szóló útmutató az adatkezelés, a régió és a támogatás tisztázásához ad további szempontokat.
Kinek fontos már most a modell azonossága?
Az auditált munkafolyamatot működtető, illetve routeren keresztül vásárló szervezeteknek érdemes már most a beszerzésben foglalkozniuk a modell azonosságával.
A pénzügyben, az egészségügyben, a jogi munkában, a közszférában vagy az informatikai biztonsági területen előfordulhat, hogy dokumentálni kell, melyik modell milyen adatot dolgozott fel. A kérdés akkor is lényeges, ha a router ár, kapacitás vagy rendelkezésre állás alapján több modell között válthat.
Az egyetlen szolgáltatót közvetlenül használó csapatok várhatnak, ha számukra az eredmény minősége a döntő, és nincs szükségük a pontos súlykészlet kriptográfiai igazolására. A hosszú dokumentumokat feldolgozó vagy sampled decodingra épülő munkafolyamatokhoz a FlashProve jelenlegi korlátai miatt szintén korai pilotot indítani.
| Helyzet | Mai döntés | Indok |
|---|---|---|
| Harmadik fél routerét használod auditált folyamatban | Vedd fel a modell azonosságát a beszerzési feltételek közé | A router másik modellhez küldheti a kérést |
| Közvetlen szolgáltatót használsz alacsony ellenőrzési igénnyel | Tartsd figyelőlistán | Nincs megvásárolható FlashProve-szolgáltatás |
| Nyilvánosan elérhető súlyokkal futó MoE modellhez keresel ellenőrzési módszert | Nézd át a kiadást | A kód, a Lean proofok és a dokumentáció Apache 2.0 licenc alatt érhető el |
| Hosszú dokumentumot vagy sampled decodinggal készült kimenetet kezelsz | Várj a technikai bővítésre | Az 1 024 tokenes kontextus és a greedy decoding feltétele nem felel meg ennek a feladatnak |
Mikor vizsgáld felül a beszerzési döntést?
Akkor vizsgáld felül a döntést, amikor egy szolgáltató az általad ténylegesen használt modellhez kínál ellenőrizhető proofot, dokumentált árral és működési feltételekkel.
A döntés előtt ellenőrizd, hogy a szolgáltatás támogatja-e a használt decoding módot, a szükséges kontextushosszt és a tokenfolyam ellenőrizendő részét. Kérj adatot a proof elkészítési idejéről, méretéről, ellenőrzési költségéről és arról, mi történik sikertelen ellenőrzésnél. Nézd meg azt is, hogyan kapcsolódik a gyors verifier a formálisan ellenőrzött specifikációhoz. A FlashProve gyors C++ verifieréhez az Anthropic nem ad formális garanciát, bár a vállalat tesztjeiben azonos eredményt adott a Lean verifierrel.
Először térképezd fel a kérések jelenlegi útját. Írd össze, melyik alkalmazás melyik szolgáltatót, routert és modellazonosítót használja. Vesd össze az alkalmazásnaplót a szolgáltatói naplóval, és dokumentáld a fallback működését. Ez feltárja, hol hiányzik a modellválasztás utólagos ellenőrizhetősége.
Nyitott kérdés, hogy a felhőszolgáltatók kínálnak-e, és ha igen, mikor, ilyen proofot a kereskedelmi modellek tényleges forgalmához.
 Ábra megnyitása teljes méretben
Az ábra adatai táblázatban
| Ennyiszeres GPU-idő kellett a proof elkészítéséhez | × |
|---|---|
| 24 kéréses összevetés | 72 |
| Legnagyobb tesztelt vLLM-terhelés | 94 |