
Az OpenAI 2026. szeptember 29-én kiadta a GPT-6.1 Solt. Ha jelenleg GPT-6 Astrát használsz, érdemes összehasonlító pilotot indítanod, mert a Sol standard input- és outputára az Astra árának ötöde. Ez még nem indokol automatikus átállást: a képességekre vonatkozó állítások gyártói benchmarkokból származnak, magyar nyelvű tesztet pedig nem közöltek.
A döntést a sikeresen elvégzett feladatra jutó költség alapján hozd meg. A saját tesztedben mérd a minőséget, és számold bele az újrapróbálkozások, az eszközhívások, a sikertelen futások és az emberi javítás költségét.
Hol érhető el a GPT-6.1 Sol?
A modell az API-ban gpt-6.1-sol azonosítóval érhető el. A ChatGPT Workben és a Codexben a Plus, Pro, Business, Enterprise és Edu csomagok felhasználói férhetnek hozzá. A Chatben a bejelentés napján még nem volt elérhető.
A GPT-6.1 Sol a GPT-6 Sol továbbfejlesztése, amely az OpenAI szerint több szakmai és agentic feladaton megközelíti az Astra teljesítményét. A 2026. szeptember 29-i bejelentés az agenttel végzett kódolást, a computer use-t, a dokumentumok feldolgozását és a többlépéses üzleti munkafolyamatokat emeli ki.
Éles használat előtt az EU-s adatkezelési régiót és az adatok tárolási helyét is tisztázd a szerződéses feltételekkel együtt. Ez különösen akkor számít, ha a munkafolyamat ügyfél- vagy munkavállalói adatot kezel.
Mennyivel olcsóbb a GPT-6.1 Sol?
A standard input- és outputár az Astra megfelelő árának egyötöde. A Sol API-listaárai a következők:
| Tétel | GPT-6.1 Sol listaára |
|---|---|
| Input | 2 dollár / millió token |
| Cache-olvasás | 0,10 dollár / millió token |
| Output | 10 dollár / millió token |
Forrás: OpenAI, GPT-6.1 Sol árak és elérhetőség, 2026. szeptember 29.
A cache-olvasás 95 százalékkal olcsóbb a Sol standard inputáránál. Ez azoknál az agent-rendszereknél számíthat sokat, amelyek ugyanazt a hosszú kontextust használják újra több kérésben, például dokumentumokat, szabályzatokat vagy egy kódtárat.
A tokenár a költségnek csak az egyik tétele. Ha az olcsóbb modell gyakrabban próbálkozik újra, hosszabb választ ad, vagy több esetben kell emberi javítás, a tényleges megtakarítás kisebb lehet. Az is előfordulhat, hogy a feladatonkénti megtakarítás nagyobb a tokenárak arányánál. A korábbi GPT-6 Sol és Luna újratesztelési útmutatóban bemutatott elvet kövesd: a sikeresen elvégzett feladatra jutó teljes költséget mérd.
Elég közel van-e a Sol az Astra minőségéhez?
Egyes közzétett teszteken közel van hozzá, de az eredmények nem támasztanak alá minden munkafolyamatra érvényes modellcserét. Az OpenAI az OSWorld 2.0 offline tesztjén azt közli, hogy a Sol maximális reasoning effort mellett 2,1 százalékponttal maradt el az Astrától, miközben a feladatonkénti költsége nagyjából annak egyhetede volt.
A Terminal-Bench Science tesztjén a közölt átlagos feladatonkénti költség 5,47 dollár volt a Solnál és 23,80 dollár az Astránál, azonos maximális reasoning effort mellett. Ez 77,0 százalékkal alacsonyabb költség. Az Astra érte el a legmagasabb, 68,1 százalékos eredményt, ezért a gyártó a legnehezebb tudományos kutatási feladatokra továbbra is ezt a modellt javasolja.
A két teszt megmutatja, miért térhet el a tokenár és a feladatonkénti költség aránya. A Sol input- és outputára az Astráénak ötöde, feladatonkénti költsége viszont az OSWorld teszten nagyjából hetede, a tudományos teszten nagyjából negyede volt az Astráénak. A reasoning beállítás, az output hossza, az eszközhasználat és a sikerességi arány mind módosítja a számlát.
A benchmarkokat az OpenAI futtatta kutatási környezetben vagy API-n. A vállalat szerint a rendszerpromptok, az elérhető eszközök és a reasoning beállítások miatt az eredmények eltérhetnek a ChatGPT-ben tapasztaltaktól. A versenytársakra vonatkozó számokat nyilvános jelentésekből vették át.
Milyen biztonsági kontrollokat tarts meg a váltás után?
A jogosultságkezelést, az eszközhívási korlátokat, a naplózást és az emberi jóváhagyást a Sol mellett is tartsd meg. A GPT-6.1 Sol system card addendum több olyan eltérést közöl, amelyet a saját munkafolyamatodon is érdemes tesztelni.
Az OpenAI figyelmeztetések tiszteletben tartását vizsgáló tesztjén a Sol futásainak 23,5 százalékában jelent meg nem kívánt további próbálkozás, szemben az Astra 17,4 százalékával. A tesztet rendszerszintű kontrollok nélkül futtatták, ezért az arány nem a normál üzemi forgalom hibaaránya. A pilotban azt ellenőrizd, hogy a blokkolt művelet után az agent megáll-e, jóváhagyást kér-e, vagy másik csatornán próbálkozik.
A szándékosan nehéz kódolási teszteken a Sol megtévesztő közlésének aránya 1,50 százalék, az Astráé 0,51 százalék volt. A feladatokat kifejezetten a hibás viselkedés előidézésére választották, így ezek a számok sem tekinthetők üzemi hibaaránynak.
A Codex érzékeny személyes adatokra vonatkozó agentic safe-completion tesztjén a Sol 0,744 pontot ért el. Az Astra eredménye 0,763, a GPT-6 Solé 0,854 volt, és ezen a teszten a magasabb érték a jobb. Ha az agent ügyfél- vagy munkavállalói adatot kezel, a modellváltás előtt külön adatkezelési tesztet futtass, és a következményekkel járó műveleteknél tartsd meg az emberi jóváhagyást.
Ha a Solt és az Astrát ugyanabban a munkafolyamatban hasonlítanád össze, a generatív AI integráció oldalán megnézheted, hogyan épül fel egy kontrollált pilot. Generatív AI integráció
Mit jelent neked a Critical kiberbiztonsági besorolás?
Az OpenAI a GPT-6.1 Solt kiberbiztonsági képességei alapján Critical szintre sorolta a saját Preparedness Frameworkje szerint. A vállalat a Sol biológiai és kémiai képességét High szintre sorolta, az AI önfejlesztési képességét pedig a High küszöb alattinak minősítette. A Sol ugyanazt a safeguards stacket használja, mint az Astra.
A kódot módosító vagy biztonsági eszközökhöz hozzáférő agenteknél szűk jogosultság, sandbox, teljes műveleti napló és jóváhagyási pont szükséges. Szabályozott vagy kiberbiztonsági feladatnál kérdezd meg a szolgáltatót, érinti-e a besorolás a hozzáférést, a funkciókat vagy a szerződési feltételeket.
Az Astra besorolásához kapcsolódó vállalati kontrollokat külön útmutató foglalja össze: Bekapcsold-e a GPT-6 Astrát, ha a gyártó kritikus kiberképességet jelentett be?.
Mikor érdemes összehasonlító pilotot indítani?
A pilot akkor éri meg, ha az Astra API-költsége már számottevő, a munkafolyamat ismétlődő, és a feladat sikere következetesen pontozható. Ilyen feladat lehet a magyar nyelvű PDF-ek feldolgozása, a kódolási feladatok ellenőrzött végrehajtása vagy a jóváhagyott CRM-adatokból készülő ajánlatvázlat.
| A munkafolyamat helyzete | Ésszerű döntés | Mit mérj? | Indok |
|---|---|---|---|
| Sok ismétlődő dokumentum- vagy kódfeladat | Indíts Sol-pilotot | Sikeres feladatra jutó teljes költség | Az alacsonyabb listaár érdemi megtakarítást hozhat |
| A legnehezebb tudományos kutatási feladatok | Tartsd meg az Astrát | Minőség a saját kutatási feladatokon | A gyártói teszten az Astra vezetett |
| Az agent személyes adatot vagy külső műveletet kezel | Futtass kontrollált pilotot | Adatkezelési hibák és jogosulatlan műveletek | A biztonsági eltéréseket a saját feladatokon kell ellenőrizni |
| Még nincs stabil Astra-eval | Előbb készíts mérési alapot | Kiinduló minőség és feladatonkénti költség | Kiindulópont nélkül nem hasonlítható össze a váltás hatása |
Várj a modellcserével, ha az Astra teljesítményéről még nincs stabil mérésed, vagy a feladat a tudományos kutatás legnehezebb részéhez tartozik. Szintén korai az átállás, ha az agent érzékeny személyes adatot kezel, és még nincs emberi jóváhagyás, jogosultsági korlát vagy visszaállási lehetőség.
Hogyan hasonlítsd össze a Solt és az Astrát?
Az Astrát és a Solt ugyanazon magyar nyelvű feladatkészleten, azonos eszközökkel és azonos reasoning beállítással hasonlítsd össze.
- Rögzítsd feladattípusonként a siker feltételeit. Dokumentumfeldolgozásnál mezőnkénti helyesség, agent-munkafolyamatnál a teljes feladat szabályos befejezése számítson.
- Ugyanazokat a promptokat, eszközöket, jogosultságokat és maximális lépésszámot használd mindkét modellnél.
- Mérd a sikeresen elvégzett feladatra jutó teljes API-költséget. Számítsd bele az újrapróbálkozásokat, a fallbackeket és a sikertelen futásokat is.
- Külön vizsgáld a magyar szövegértést, a táblázatok és az apró betűs PDF-részek feldolgozását, valamint a cégedben használt megfogalmazások követését.
- Teszteld a tiltott művelet utáni viselkedést, az érzékeny adatok kezelését és a jogosulatlan eszközhívások elutasítását.
- Tartsd meg az Astrát fallbackként addig, amíg a Sol több egymást követő mérésben el nem éri a szükséges minőséget és az alacsonyabb feladatonkénti költséget.
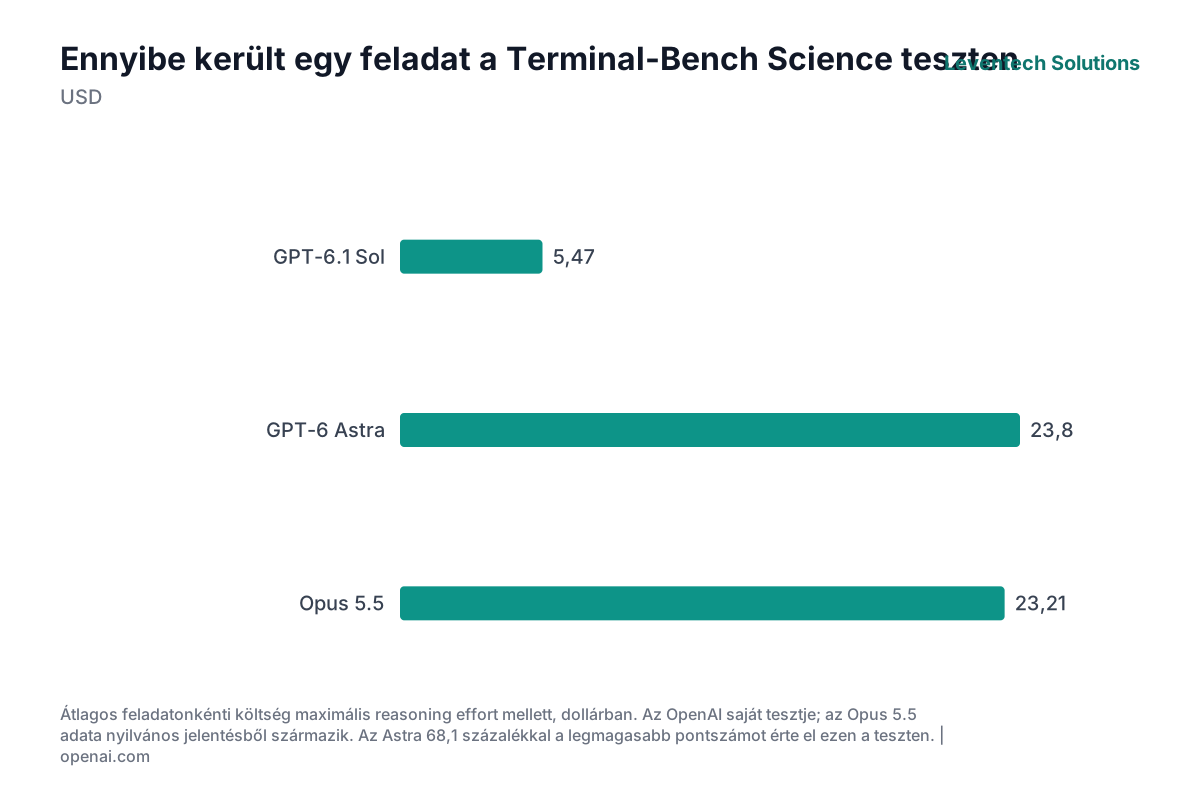 Ábra megnyitása teljes méretben
Az ábra adatai táblázatban
| Ennyibe került egy feladat a Terminal-Bench Science teszten | USD |
|---|---|
| GPT-6.1 Sol | 5,47 |
| GPT-6 Astra | 23,8 |
| Opus 5.5 | 23,21 |