
Az Anthropic 2026. szeptember 22-én kiadta a Claude Opus 5.5-öt. Az input és az output token listaára 20 százalékkal, a cache-olvasásé 60 százalékkal csökkent az Opus 5-höz képest. A gyártó tipikus munkafolyamatokra 40 százalékos teljes költségcsökkenést közöl, mert szerinte az új modell az alacsonyabb ár mellett feladatonként kevesebb tokent is használ.
Ez még nem indokol automatikus modellcserét. Ha Opus 5-öt használsz hosszan futó agentekhez, programozási feladatokhoz vagy dokumentumok feldolgozásához, érdemes összehasonlító pilotot indítanod. Ugyanazokat a magyar nyelvű feladatokat, effort-szinteket és cache-beállításokat használd, majd a sikeres feladatra jutó teljes költséget hasonlítsd össze. A kisebb modellekre épülő, nagy volumenű munkafolyamatokkal érdemes megvárni a Sonnet 5.5 és a Haiku 5.5 adatait.
Mennyivel lett olcsóbb az Opus 5.5?
Az Anthropic 2026. szeptember 22-i bejelentése szerint az Opus 5.5 listaára 4 dollár / millió input token és 20 dollár / millió output token. A cache-olvasás 0,20 dollár / millió token, a cache-írás 5 dollár / millió token.
| Díjtétel | Opus 5 | Opus 5.5 | Változás |
|---|---|---|---|
| Cache-olvasás | 0,50 dollár | 0,20 dollár | 60 százalékkal alacsonyabb |
| Input token | 5 dollár | 4 dollár | 20 százalékkal alacsonyabb |
| Output token | 25 dollár | 20 dollár | 20 százalékkal alacsonyabb |
| Cache-írás | 6,25 dollár | 5 dollár | 20 százalékkal alacsonyabb |
A táblázat egysége dollár / millió token. Forrás: Anthropic, 2026. szeptember 22.
Az Anthropic szerint a Claude Code-ban és a Claude Platformon elérhető Fast mode legfeljebb 2,5-szer gyorsabb működést kínál, 8 dollár / millió input token és 40 dollár / millió output token áron. Ez a standard Opus 5.5 díjának kétszerese. Akkor lehet indokolt, ha a válaszidőnek közvetlen üzleti értéke van, és ezt külön konfigurációként méred a pilotban.
Miért nem hoz minden cégnél 40 százalékos megtakarítást az Opus 5.5?
A 20 és a 40 százalék közötti különbség két hatásból adódik. A listaár a legtöbb díjtételnél 20 százalékkal csökkent. Az Anthropic ezenfelül azt állítja, hogy az Opus 5.5 kevesebb tokent használ fel egy feladat elvégzéséhez. A második hatást magyar nyelvű munkafolyamaton külön kell megmérni, mert a vállalat nem közöl adatot a magyar szövegek tokenizálásáról vagy a magyar nyelvű feladatok minőségéről.
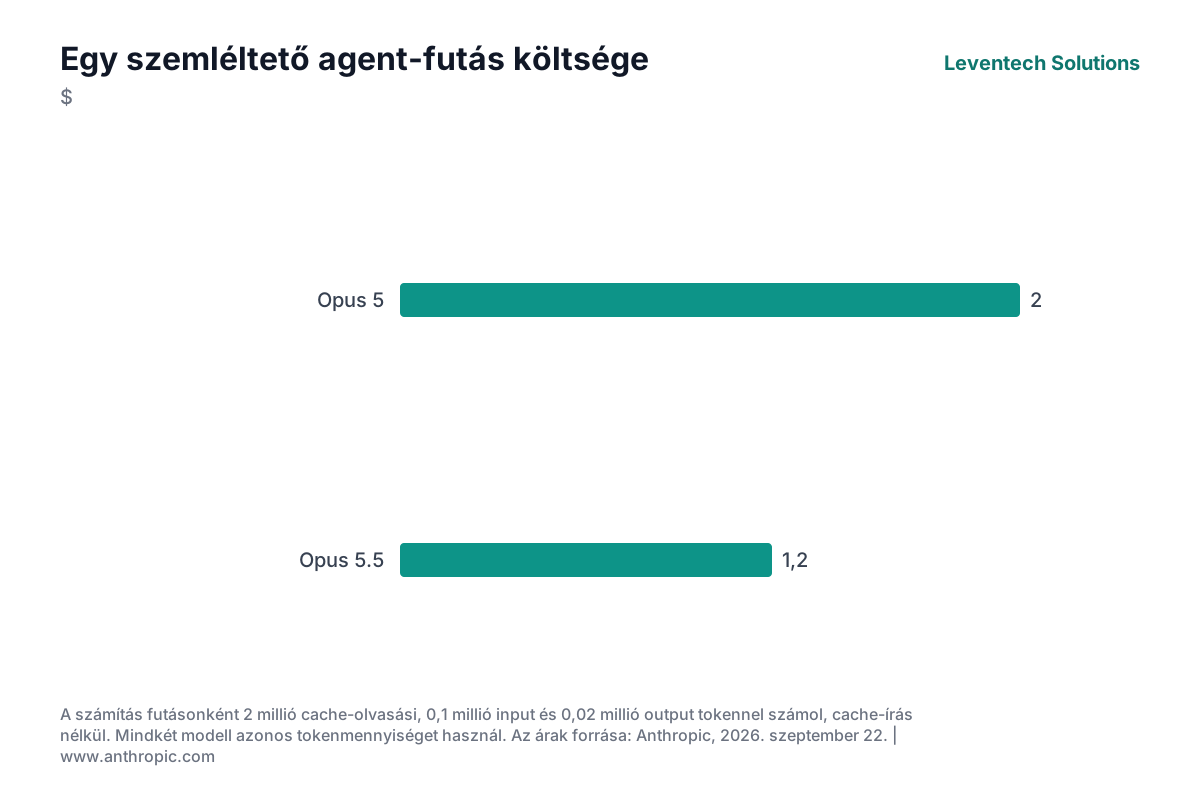
A szemléltető példa egy olyan agent-futással számol, amely 2 millió cache-olvasási, 0,1 millió input és 0,02 millió output tokent használ, cache-írás nélkül. Mindkét modellnél azonos tokenmennyiséggel számol, így a gyártó által közölt további hatékonysági javulás nincs benne.
* Opus 5: 1 dollár cache-olvasás, 0,50 dollár input és 0,50 dollár output, összesen 2 dollár. * Opus 5.5: 0,40 dollár cache-olvasás, 0,40 dollár input és 0,40 dollár output, összesen 1,20 dollár.
Ebben a cache-olvasásra épülő példában a listaárak változása önmagában 40 százalékos megtakarítást ad. Egy főként új inputból dolgozó, hosszú választ adó szövegírási feladatnál a csökkenés 20 százalék körül marad, amíg a saját teszt nem mutat alacsonyabb tokenhasználatot.
A modelleket ezért sikeres feladatra jutó költség alapján érdemes összehasonlítani. A zárt vállalati modellekről szóló útmutató további ár-, cache- és cloud-szempontokat foglal össze.
Melyik munkafolyamatnál indíts pilotot?
A legjobb jelölt az a folyamat, amely már Opus 5-ön fut, sok kontextust használ újra, és amelyről egyértelműen eldönthető, hogy sikerült-e. Ilyen lehet egy hosszú fejlesztési session, több dokumentumot feldolgozó agent vagy rendszeresen frissülő vállalati tudásbázis.
| Helyzet | Mit tegyél most? | Miért? |
|---|---|---|
| Opus 5-ön futó agent sok cache-olvasással | Indíts összehasonlító pilotot | A cache-olvasás ára 60 százalékkal csökkent |
| Hosszú választ készítő asszisztens | Mérd külön az outputot és az emberi javítás idejét | Az output token ára 20 százalékkal alacsonyabb, a további előny munkafolyamatonként eltérhet |
| Fable 5.1-en megfelelően működő folyamat | Hasonlítsd össze a költséget ugyanazokon a feladatokon | Az Anthropic Fable 5.1-szintű teljesítményt állít. A saját HAProxy-tesztjében az Opus 5.5 51 százalékkal kevesebbe került, miközben mindkét modell átment a regressziós tesztek csaknem mindegyikén. Ez gyártói teszt, ezért a minőséget a saját feladataidon is mérd meg |
| Microsoft 365 Copilotot használó csapat | Ellenőrizd a licencet, a régiót és azt, hogy a tenantban megjelent-e már a modell | A Microsoft szerint az elérhetőség licencenként, hozzáférésenként és régiónként eltérhet |
| Kisebb modellre épülő, nagy volumenű rendszer | Várd meg a Sonnet 5.5 és a Haiku 5.5 adatait | Az Anthropic ezeket a bejelentést követő hetekre ígérte |
Magyar nyelvű pilotban legyenek toldalékolt kifejezések, ragozott nevek, hosszú összetett mondatok, táblázatok és a folyamatra jellemző helyi iratok. Ilyen lehet beszállítói szerződés, közbeszerzési melléklet vagy NAV Online Számla-export, ha a rendszer ezeket kezeli. Használj 30–50 valódi, anonimizált feladatot. Mérd a helyes válaszok arányát, az emberi javítás idejét, az eszközhívások számát, a futási időt és a tokenfelhasználást típusonként.
Egy éles agentnél a modell csak egy része a rendszernek. Az eszközhívások, jogosultságok, naplózás és emberi jóváhagyás tervezéséről az AI agent fejlesztés oldalon találsz további szempontokat.
Melyik csatorna illik az adatkezelési igényhez?
Az Anthropic Opus-termékoldala szerint az Opus 5.5 a Claude Platform mellett AWS-en, Google Cloudon és Microsoft Foundryban is elérhető. A csatornát az adat helye, a meglévő szerződések, a jogosultságkezelés és az üzemeltetési eszközök alapján válaszd.
Az AWS közleménye szerint az Amazon Bedrock alapértelmezetten támogatja a Zero Data Retentiont, az adatokat pedig az AWS infrastruktúráján belül, régiós elhelyezéssel kezeli. A konkrét AWS-régió és a szolgáltatási feltételek ellenőrzése ettől még a beszerzés része.
A Microsoft ugyanazon a napon kezdte meg az Opus 5.5 és az OpenAI GPT-6 Sol bevezetését a Wordben, az Excelben, a PowerPointban, a Chatben, a Coworkben és a Copilot Studio felületén. A Microsoft tájékoztatója jelzi, hogy az elérhetőség a licenctől, a hozzáféréstől és a régiótól függhet. Egy magyar tenantnál ezért a Microsoft AI at Work Roadmap és a Microsoft Copilot release notes alapján ellenőrizd az állapotot.
Az Anthropic termékoldala US-only inference lehetőséget közöl 1,1-szeres input- és outputáron, EU-only inference opciót viszont nem nevez meg. Ha az adatok helye szerződéses feltétel, a csatornát az adatfeldolgozási feltételekkel együtt válaszd ki. A cloud és az on-premise felállás különbségeit az adatkezelési döntési útmutató foglalja össze.
Ha több modellt és cloud-csatornát hasonlítasz össze, a vállalati AI platform tervezése segít külön kezelni a modell-, adat- és üzemeltetési döntéseket. Vállalati AI platformok
Mennyire támaszkodhatsz a benchmarkokra?
Az Anthropic bejelentése szerint az Opus 5.5 vezet több programozási, computer use- és tudásmunka-benchmarkon. A vállalat azt is közli, hogy ezen a képességszinten a benchmarkokon látható különbségek egyre kevésbé megbízható támpontok a gyakorlati eltérésekhez.
Az összehasonlítások feltételei nem mindenhol azonosak. Az Opus 5.5 több eredménye max vagy xhigh effort-szinten készült, míg egyes versenytársi adatokat az OpenAI közölt. A beépített biztonsági szűrők közbelépésekor a kiberbiztonsági, biológiai és frontier LLM-fejlesztési feladatokat korábbi Claude-modellek végezték el. Az Anthropic szerint ez valószínűleg csökkentette az Opus 5.5 eredményét. Az AutomationBench tesztben a Zapier ezeket a beavatkozásokat hibának számította.
A FrontierCode leírásában az Opus 5.5 medium effort-szinten 54,6 százalékot ért el, míg a táblázat max effort mellett 54,4 százalékot közöl. A 0,2 százalékpontos eltérés önmagában nem támaszt alá döntést az effort-szintről. A pilotban ezért több effort-szintet is próbálj ki, és az eredményt a feladatonkénti költséggel együtt értékeld.
Hogyan hasonlítsd össze az Opus 5.5-öt az Opus 5-tel?
- Válassz ki 30–50 anonimizált feladatot az éles folyamatból, köztük azokat a magyar nyelvű eseteket, amelyeket ma is javítani kell.
- Futtasd ugyanazokat a promptokat Opus 5-ön és Opus 5.5-ön, azonos cache-beállításokkal és több, egymással összevethető effort-szinten.
- Használd a
claude-opus-5-5modellazonosítót, és rögzítsd a tesztben használt konfigurációt. - Külön rögzítsd az inputot, az outputot, a cache-olvasást, a cache-írást, az eszközhívásokat, a futási időt és az emberi javítás idejét.
- A sikeres feladatra jutó teljes költség alapján dönts. A tokenár önmagában nem mutatja meg a hibás próbálkozások és az ellenőrzés költségét.
- Élesítés előtt ellenőrizd a választott csatorna régióját, adatmegőrzését, licencét és hozzáférési feltételeit.
Kinek éri meg most az Opus 5.5?
Pilotot azoknak a cégeknek érdemes indítaniuk, amelyek már Opus 5-öt használnak sok cache-olvasással járó, hosszú agent-futásokhoz. A szemléltető példában a futás költsége már az új listaárakkal 40 százalékkal csökkent, kisebb tokenhasználat feltételezése nélkül.
Ha Fable 5.1-et használsz, az Opus 5.5-öt a költség miatt érdemes tesztelned ugyanazon a minőségi mércén. Ha egy kisebb modell már megfelelő minőséget ad, csak egy konkrét hiányosság miatt teszteld az Opus 5.5-öt. Ha nincs jelenlegi Opus-szintű munkafolyamatod, várd meg a Sonnet 5.5 és a Haiku 5.5 adatait. Éles váltás akkor indokolt, ha az Opus 5.5 a saját feladataidon az elvárt minőséget alacsonyabb teljes költséggel adja.
 Ábra megnyitása teljes méretben
Az ábra adatai táblázatban
| Egy szemléltető agent-futás költsége | $ |
|---|---|
| Opus 5 | 2 |
| Opus 5.5 | 1,2 |